Kubernetes ha rivoluzionato il modo in cui le infrastrutture vengono utilizzate. Oggi gli sviluppatori non devono più aprire un ticket ogni volta che necessitano di risorse di calcolo. Definiscono l’applicazione, richiedono le risorse necessarie e lasciano che la piattaforma si occupi di pianificazione, scalabilità, riavvii ed esposizione dei servizi.
Questo approccio ha trasformato il ciclo di sviluppo e rilascio delle applicazioni. Tuttavia, per molti team, lo storage persistente continua a essere gestito con logiche appartenenti a un’altra epoca.
Quando uno sviluppatore crea una PersistentVolumeClaim (PVC), dietro quella semplice richiesta si cela ancora una lunga serie di decisioni infrastrutturali: classi di storage, driver CSI, livelli prestazionali, modalità di accesso, snapshot, replica, pianificazione della capacità, policy di backup e, spesso, l’apertura di un ticket verso il team storage. Lo YAML può apparire cloud-native, ma il modello operativo che lo sostiene spesso non lo è.
Ed è proprio questo il vero problema: lo storage in Kubernetes non è soltanto una questione infrastrutturale. È una questione di esperienza dello sviluppatore.
Gli sviluppatori non vogliono conoscere array, LUN, zoning, gruppi disco, tipologie di replica o policy del backend storage. Vogliono semplicemente disporre di volumi persistenti affidabili, quando servono e senza complessità aggiuntive.
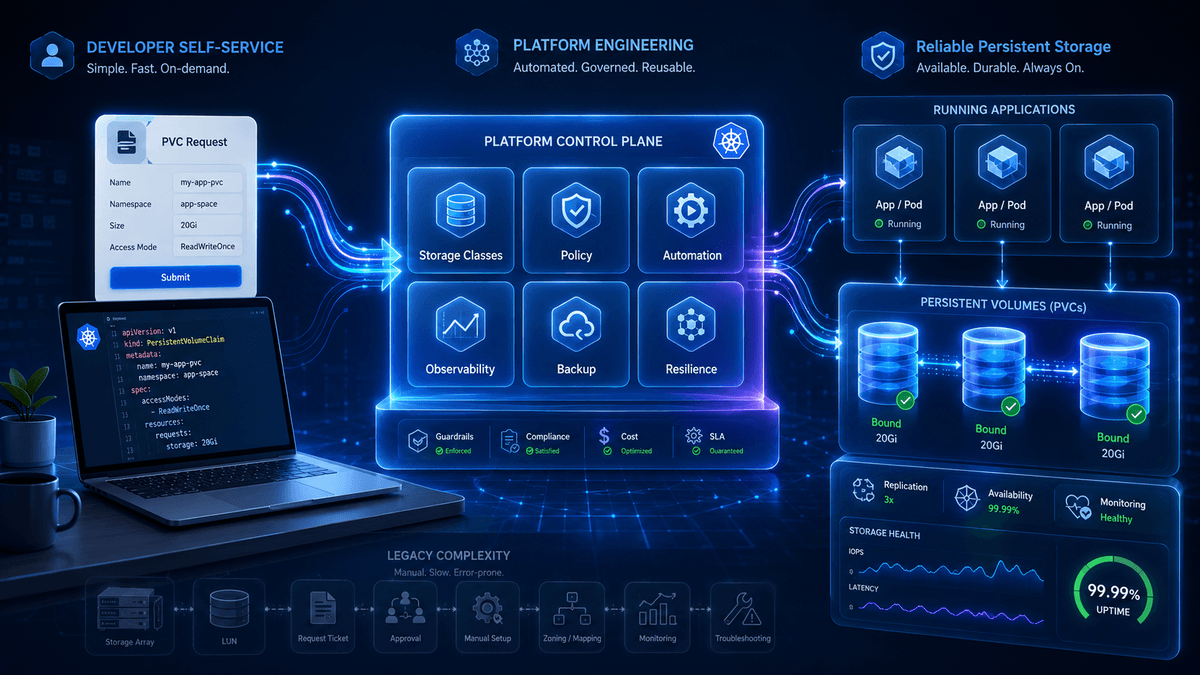
Si aspettano che lo storage funzioni come il resto della piattaforma: self-service, automatizzato, osservabile e governato. È qui che entra in gioco il Platform Engineering.
L’obiettivo non è trasformare ogni sviluppatore in uno specialista dello storage, ma costruire una piattaforma in cui le competenze infrastrutturali siano integrate nel sistema. In questo modo gli sviluppatori possono utilizzare lo storage persistente in tutta sicurezza senza attendere provisioning manuali né confrontarsi con la complessità sottostante.
La PVC è solo il punto di partenza
Kubernetes mette a disposizione un’astrazione semplice ed efficace per la gestione dello storage persistente: la PersistentVolumeClaim.
Uno sviluppatore può richiedere storage con poche righe di configurazione:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: postgres-data
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: fast-replicated
  resources:
    requests:
      storage: 500Gi
A prima vista, è esattamente ciò che ci si aspetta da un’infrastruttura cloud-native: lo sviluppatore dichiara la necessità e la piattaforma provvede automaticamente ad allocare le risorse richieste. Ma la PVC è soltanto il livello superficiale dell’esperienza. Dietro quella richiesta si nascondono domande fondamentali:
Le prestazioni offerte sono adeguate? Il volume è replicato? Può essere espanso dinamicamente? È incluso nei processi di backup? Cosa accade in caso di guasto del nodo? I team SRE possono monitorarne capacità, latenza e stato di salute? La classe di storage è certificata per la produzione?
Se le risposte a queste domande risiedono nella conoscenza informale dei team, in conversazioni Slack o in una coda di ticket, la PVC non ha risolto il problema: l’ha semplicemente rimandato fino al momento della messa in produzione. Una piattaforma efficace non si limita a esporre lo storage. Lo rende comprensibile, affidabile e sicuro da utilizzare.
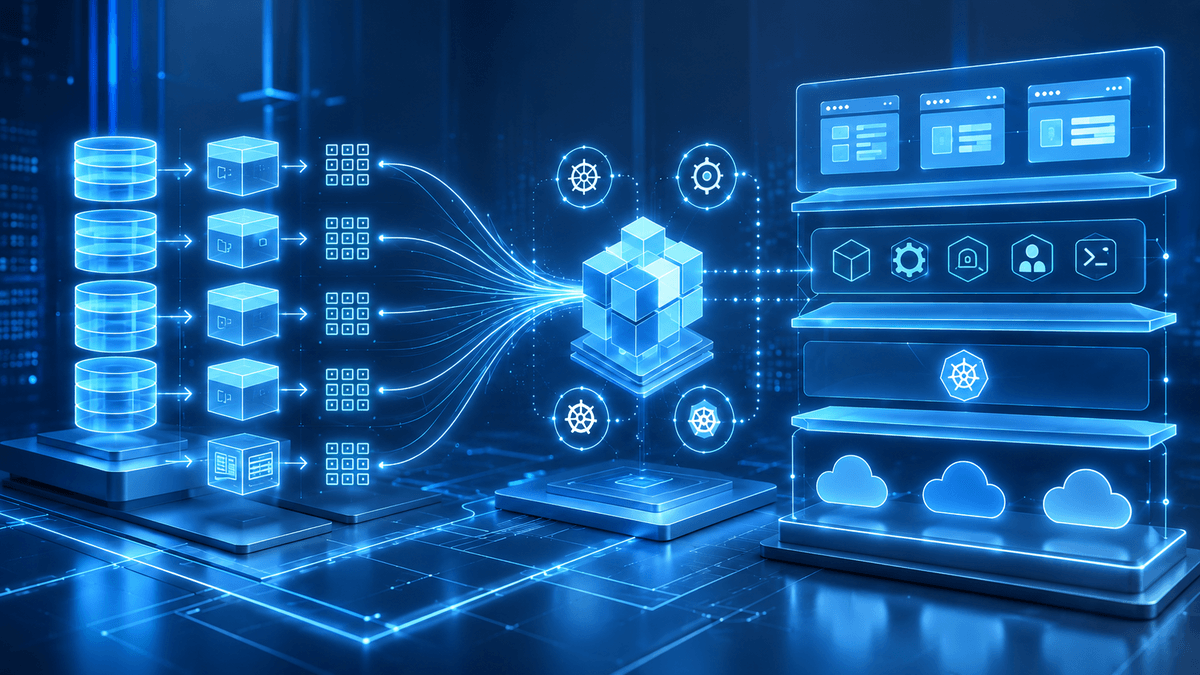
L’attrito dello storage rallenta il rilascio delle applicazioni
I problemi legati allo storage raramente compaiono nei report sulla produttività, ma vengono percepiti immediatamente dagli sviluppatori.
Un team vuole distribuire un database PostgreSQL, ma non sa quale classe di storage utilizzare. Un team dati desidera testare Kafka, ma non dispone di indicazioni sulle prestazioni necessarie. Un team SRE deve ripristinare un namespace dopo un incidente, ma i processi di recupero dei dati e dell’applicazione sono separati. Uno sviluppatore necessita di maggiore capacità, ma la richiesta richiede ancora approvazioni manuali.
Presi singolarmente, questi ostacoli sembrano marginali. Sommati nel tempo, diventano una barriera significativa alla velocità di innovazione.
Il problema non è la lentezza dei team storage né la mancanza di attenzione degli sviluppatori. Il vero problema è che i processi spesso non sono stati progettati per un modello operativo cloud-native. Le tradizionali operazioni storage sono nate per essere gestite da specialisti infrastrutturali. Kubernetes, invece, è stato costruito intorno al concetto di self-service.
Quando lo storage continua a dipendere dai ticket, l’intera piattaforma rallenta.
Le classi di storage devono diventare prodotti della piattaforma
Il Platform Engineering punta a creare percorsi standardizzati e sicuri verso la produzione. Lo stesso principio dovrebbe essere applicato allo storage.
Invece di offrire agli sviluppatori un elenco di classi dalle definizioni vaghe come gold, silver, premium o standard, i platform team dovrebbero costruire servizi di storage pensati per specifici casi d’uso:
- dev-standard per ambienti di sviluppo e test
- database-ha per database di produzione ad alta disponibilità
- local-nvme per workload sensibili alla latenza che gestiscono autonomamente la replica
- analytics-throughput per elaborazioni ad alto throughput
- edge-replicated per ambienti distribuiti o sedi remote
Questi non sono semplici nomi: sono contratti operativi. Ogni servizio dovrebbe comunicare chiaramente:
Livello di prestazioni atteso; disponibilità della replica; copertura di backup; possibilità di espansione; idoneità all’uso in produzione; comportamento in caso di guasto.
La domanda che uno sviluppatore dovrebbe porsi non è: “Quale array devo utilizzare?”, ma piuttosto: “Quale servizio di storage è adatto al mio workload?”
Self-service non significa assenza di governance
Una delle preoccupazioni più comuni riguarda il rischio che il self-service generi caos. Tuttavia, la soluzione non consiste nel tornare al modello basato sui ticket, bensì nell’automazione della governance.
Kubernetes mette già a disposizione gli strumenti necessari: RBAC, Admission Controller, policy di namespace, quote delle risorse, label e annotazioni, workflow GitOps. Grazie a questi strumenti è possibile definire quali classi di storage possono essere utilizzate in produzione, quali devono essere sottoposte a backup e quali sono consentite solo in specifici contesti applicativi.
La migliore esperienza per gli sviluppatori non è la libertà assoluta, ma la libertà all’interno di confini sicuri.
L’osservabilità rende lo storage affidabile
Nei workload stateful, i problemi di storage spesso si manifestano come problemi applicativi. Un database rallenta, un pod si riavvia, una coda cresce oltre il previsto o un servizio non rispetta gli SLA di latenza.
Gli sviluppatori vedono il sintomo applicativo. I platform team osservano gli eventi Kubernetes. I team storage monitorano il backend. Se queste informazioni rimangono separate, ogni incidente rischia di trasformarsi in una lunga “war room”. Per questo motivo l’osservabilità dello storage deve essere strettamente integrata nel piano di controllo Kubernetes.
I team devono poter rispondere rapidamente a domande come:
- Quali PVC stanno esaurendo la capacità disponibile?
- Quali workload utilizzano volumi non replicati?
- Quali volumi sono ospitati su nodi degradati?
- Quali applicazioni stateful stanno registrando latenza elevata?
- Quali namespace stanno consumando la maggior parte dello storage disponibile?
La visibilità genera fiducia negli sviluppatori e consente ai team operativi di intervenire in modo efficace.
Perché lo storage container-native è fondamentale
Le piattaforme storage tradizionali offrono funzionalità avanzate, ma spesso non sono state progettate avendo Kubernetes come modello operativo principale. Lo storage container-native cambia questo paradigma.
Si integra direttamente con le API Kubernetes e utilizza concetti nativi come PVC, Storage Class, Node, Label e Operator. In questo modo lo storage diventa una componente della piattaforma e non una dipendenza esterna.
L’importanza di questo approccio cresce ulteriormente quando si utilizzano risorse locali NVMe o SSD. Queste possono offrire prestazioni eccellenti, ma richiedono replica, snapshot, gestione dei guasti, backup e monitoraggio.
Senza un livello storage realmente container-native, i dischi locali rischiano di diventare risorse isolate, difficili da amministrare e legate a singoli nodi.
L’obiettivo è rendere disponibili prestazioni elevate attraverso la stessa esperienza Kubernetes che gli sviluppatori già conoscono. Lo storage non dovrebbe semplicemente essere collegato a Kubernetes. Dovrebbe comportarsi come una componente nativa della piattaforma.
Il ruolo di DataCore Puls8
DataCore Puls8 è una piattaforma di storage persistente container-native progettata per ambienti Kubernetes. Consente ai platform team di trasformare lo storage locale dei nodi in volumi persistenti dotati di automazione, resilienza e osservabilità.
Gli sviluppatori continuano a utilizzare strumenti familiari come PVC e Storage Class, mentre i platform team definiscono policy, classi di servizio e requisiti operativi in modo centralizzato.
Il risultato è un modello operativo più efficiente: provisioning più rapido per gli sviluppatori, maggiore coerenza operativa, riduzione delle attività manuali e migliore collaborazione tra team applicativi e infrastrutturali.
Lo storage fa ormai parte della Developer Platform
Kubernetes ha cambiato le aspettative degli sviluppatori. Oggi ci si aspetta che l’infrastruttura sia programmabile, disponibile in self-service, osservabile e coerente tra gli ambienti. Lo storage persistente deve soddisfare gli stessi standard.
Le organizzazioni che riusciranno a gestire con successo workload stateful su Kubernetes non saranno quelle che semplicemente collegano uno storage ai cluster. Saranno quelle che riusciranno a trasformarlo in un vero servizio di piattaforma: automatizzato, governato, osservabile, resiliente e semplice da utilizzare. Questo è il passaggio fondamentale dalle Persistent Volume Claim al Platform Engineering.
Lo storage non è più soltanto un livello tecnologico sotto l’applicazione: è diventato una parte integrante dell’esperienza dello sviluppatore e, di conseguenza, una componente strategica dell’infrastruttura moderna.
Volete semplificare lo storage persistente Kubernetes per i vostri team di piattaforma e di sviluppo? Provate DataCore Puls8 con un download gratuito di 30 giorni.


