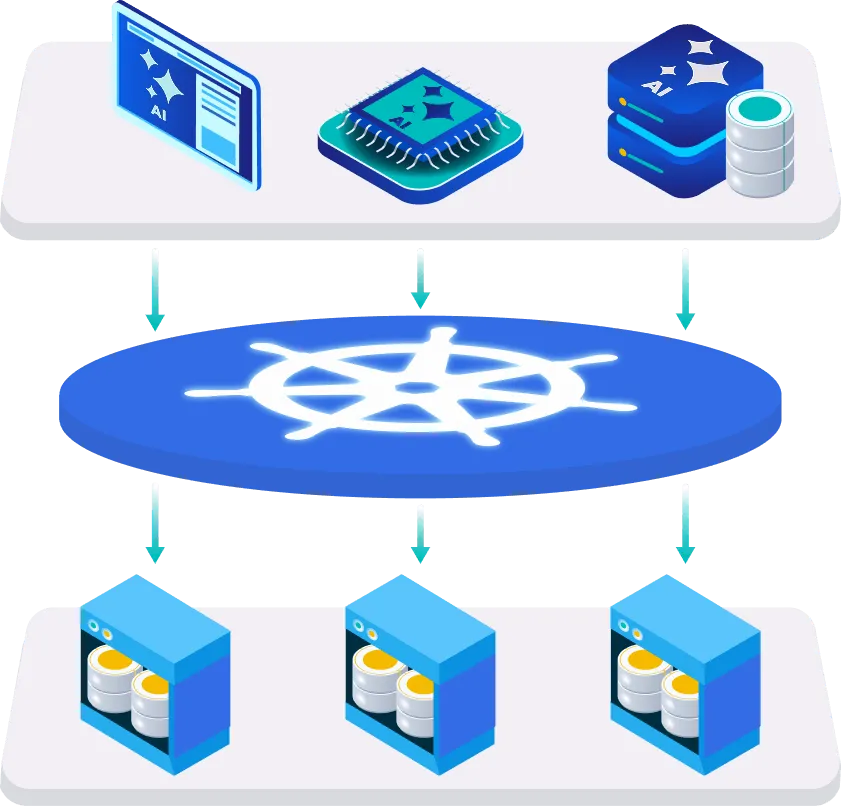
 L’intelligenza artificiale sta trasformando il modo in cui si parla di infrastrutture IT, anche se non sempre nella direzione suggerita dall’hype del momento. Non tutti i carichi di lavoro AI vengono eseguiti su Kubernetes. Molti ambienti dedicati all’addestramento dei modelli continuano infatti ad affidarsi a sistemi specializzati, infrastrutture bare-metal ad alte prestazioni, file storage ad accesso rapido e cluster GPU gestiti in modo altamente controllato. Tuttavia, Kubernetes sta assumendo un ruolo sempre più centrale nell’ecosistema AI.
Quando le organizzazioni superano la fase sperimentale e iniziano a portare l’AI in produzione, emerge la necessità di distribuire, scalare, gestire e aggiornare i servizi in modo ripetibile e standardizzato. Questo riguarda ambienti di sviluppo dei modelli, applicazioni di inferenza, pipeline dati, database vettoriali, servizi di analisi e molte altre applicazioni containerizzate. Kubernetes offre un piano di controllo unificato che consente di eseguire e orchestrare questi carichi di lavoro in ambienti diversi.
La sfida è che i workload AI raramente sono semplici o stateless. Dipendono da dati, modelli, checkpoint, metadati, log e servizi persistenti. Per questo motivo, lo storage non rappresenta più un elemento secondario, ma una componente fondamentale dell’architettura.
L’AI rende Kubernetes sempre più “stateful”
In origine, Kubernetes era associato soprattutto ad applicazioni stateless, come servizi web, API e microservizi che possono essere riavviati o riprogrammati senza particolari implicazioni per i dati locali. I carichi di lavoro AI hanno esigenze differenti.
Un servizio di inferenza può richiedere un accesso immediato ai file dei modelli. Un database vettoriale necessita di volumi persistenti affidabili. Una pipeline dati deve conservare gli output intermedi, mentre un processo di training genera checkpoint che non possono essere persi. Inoltre, i team di sviluppo hanno spesso bisogno di ambienti condivisi in cui notebook, strumenti e servizi possano accedere agli stessi dati.
In questo contesto, il container non è più una semplice unità di elaborazione temporanea, ma parte integrante di un flusso operativo che dipende dallo stato persistente delle informazioni. Ne deriva un’esigenza fondamentale: lo storage deve seguire il ritmo e la flessibilità di Kubernetes senza rinunciare all’affidabilità richiesta dagli ambienti enterprise.
Le prestazioni continuano a essere fondamentali
I team che sviluppano soluzioni AI sono particolarmente sensibili alle prestazioni dello storage, perché qualsiasi collo di bottiglia emerge immediatamente. Uno storage lento può rallentare la preparazione dei dati, ridurre la velocità di iterazione sui modelli, aumentare la latenza delle inferenze e lasciare inutilizzate costose risorse GPU.
Non tutti i workload AI distribuiti su Kubernetes richiedono prestazioni estreme, ma quasi tutti necessitano di prestazioni costanti e prevedibili. Ciò significa garantire elevati livelli di I/O, bassa latenza quando necessaria e accesso uniforme ai dati anche in presenza di carichi variabili.
È inoltre importante considerare l’intero ciclo di vita dell’intelligenza artificiale. L’infrastruttura non riguarda esclusivamente il training dei modelli, ma comprende acquisizione e preparazione dei dati, sperimentazione, distribuzione, monitoraggio e riaddestramento. Ogni fase può imporre requisiti differenti allo storage.
Per questo motivo, una piattaforma che eccelle in un unico scenario potrebbe non essere sufficiente. Lo storage per Kubernetes deve supportare contemporaneamente database, pipeline, applicazioni e strumenti AI senza costringere i team a implementare soluzioni complesse o workaround.
La persistenza deve essere affidabile
 Per i carichi di lavoro AI eseguiti su Kubernetes, la persistenza non è un’opzione ma una necessità. I pod possono essere spostati, i nodi possono guastarsi e le applicazioni possono essere riavviate. Lo storage deve garantire che i dati restino integri e disponibili durante questi eventi. Questo aspetto è particolarmente importante per componenti stateful come database, feature store, servizi di metadati, repository di modelli e backend applicativi. La perdita dello stato può tradursi in lavoro perso, pipeline compromesse, interruzioni operative o problemi in produzione.
Per questo motivo, lo storage deve offrire funzionalità affidabili di persistenza, replica, snapshot e ripristino. I team devono poter contare sul fatto che, quando Kubernetes riprogramma un workload, i dati lo seguano in modo sicuro e prevedibile. Senza queste garanzie, Kubernetes rischia di essere adatto solo a progetti pilota e sperimentazioni limitate.
Lo storage Kubernetes deve essere semplice da gestire
I team AI operano già in un contesto complesso, caratterizzato dalla gestione di pipeline dati, versioni dei modelli, GPU, framework, strategie di deployment, requisiti di sicurezza e controllo dei costi. Lo storage non dovrebbe aggiungere ulteriore complessità.
In un ambiente Kubernetes, lo storage deve integrarsi naturalmente nei processi operativi esistenti, offrendo provisioning dinamico, integrazione con le API standard della piattaforma, automazione e visibilità sulle capacità e sulle prestazioni.
Gli sviluppatori e gli ingegneri di piattaforma non dovrebbero essere costretti ad aprire ticket ogni volta che necessitano di un volume persistente. Dovrebbero poter richiedere le risorse direttamente tramite Kubernetes, mentre i team infrastrutturali mantengono il controllo su policy, protezione e utilizzo. Questo equilibrio è essenziale: i team AI richiedono velocità e agilità, mentre l’IT ha bisogno di governance e controllo.
La resilienza è un requisito della piattaforma AI
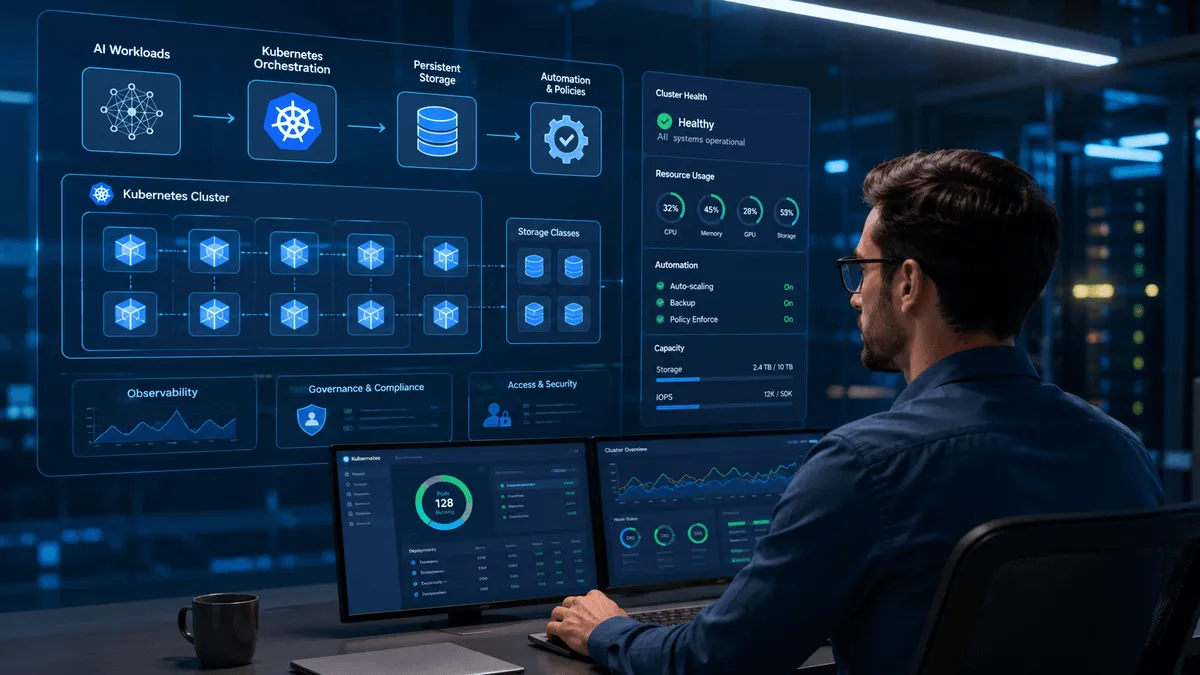
Con il passaggio dall’ambito sperimentale alla produzione, la resilienza diventa un fattore critico. Se un ambiente di test può tollerare brevi interruzioni, servizi di inferenza in produzione, applicazioni rivolte ai clienti e analisi mission-critical richiedono continuità operativa elevata. Lo storage deve quindi supportare meccanismi di alta disponibilità, replica, failover, snapshot e recupero rapido in caso di errori o guasti.
Gli snapshot assumono un ruolo particolarmente importante nei contesti AI, poiché consentono di preservare stati affidabili, proteggere dataset strategici e tornare rapidamente a configurazioni precedenti dopo modifiche o aggiornamenti. Con la crescita della complessità dei flussi dati e dei modelli, la capacità di ripristino diventa parte integrante delle pratiche operative quotidiane. L’obiettivo non è semplicemente mantenere in funzione le applicazioni, ma anche salvaguardare il patrimonio informativo e gli artefatti che generano valore per il business.
Portabilità e ambienti ibridi
Molte organizzazioni adotteranno strategie AI distribuite su più ambienti. Alcuni workload rimarranno on-premises per motivi di conformità, prestazioni, sovranità del dato o controllo dei costi. Altri verranno eseguiti nel cloud per beneficiare di maggiore elasticità o di servizi gestiti. In molti casi verranno utilizzati entrambi gli approcci.
Kubernetes contribuisce a uniformare la gestione tra questi ambienti, ma lo storage rappresenta spesso il principale fattore limitante. Se i dati persistenti risultano difficili da trasferire, proteggere o amministrare attraverso infrastrutture differenti, la portabilità diventa solo teorica. Per questo motivo, le strategie di storage per l’AI devono considerare attentamente dove risiedono i dati, come vengono utilizzati dalle applicazioni e quali sono le implicazioni di eventuali migrazioni dei workload. Quanto più un’applicazione è stateful, tanto più l’architettura dello storage diventa un elemento strategico.
Il costo non può essere trascurato
L’infrastruttura AI può diventare rapidamente onerosa. GPU, servizi cloud, crescita dei dati e storage ad alte prestazioni esercitano una pressione crescente sui budget IT. I costi dello storage, in particolare, vengono spesso sottostimati. I workload AI producono enormi quantità di dati, inclusi dataset originali, dati elaborati, checkpoint, log, versioni dei modelli e output derivati. Sebbene il cloud garantisca semplicità e flessibilità, nel lungo periodo i costi associati alla capacità di storage, alle prestazioni richieste e al trasferimento dei dati possono diventare significativi.
Per questo motivo, le organizzazioni necessitano di soluzioni che bilancino prestazioni, resilienza e sostenibilità economica, valutando il costo totale di possesso nel tempo e non soltanto la rapidità della distribuzione iniziale.
Cosa deve offrire lo storage Kubernetes per l’AI
Per supportare efficacemente i carichi di lavoro AI, lo storage Kubernetes deve essere persistente e affidabile, performante e prevedibile, resiliente e facilmente recuperabile, semplice da amministrare e nativamente integrato con Kubernetes. Deve inoltre offrire provisioning dinamico per gli sviluppatori, controllo e governance per gli operatori IT e affidabilità per gli ambienti di produzione.
Una piattaforma storage cloud-native deve adattarsi al modo in cui i team moderni lavorano realmente: iterazioni rapide, deployment frequenti, workload eterogenei e requisiti di dati in continua crescita. Kubernetes può fornire il livello di orchestrazione necessario alle applicazioni AI containerizzate, ma senza una solida base storage diventa difficile trasformare i progetti pilota in piattaforme di produzione realmente affidabili.
Il ruolo di DataCore Puls8
DataCore Puls8 è una soluzione progettata per le organizzazioni che eseguono workload stateful su Kubernetes. Offre storage persistente nativo per container attraverso un driver CSI, provisioning dinamico, elevate prestazioni IOPS, replica, snapshot e una gestione semplificata degli ambienti Kubernetes.
Per i team che intendono portare i carichi di lavoro AI in ambienti containerizzati, Puls8 contribuisce a colmare una delle principali lacune infrastrutturali: fornire alle applicazioni Kubernetes uno storage persistente, veloce, resiliente e semplice da amministrare.
In definitiva, l’intelligenza artificiale non riduce l’importanza dello storage. Al contrario, ne evidenzia il ruolo strategico. Con la crescente adozione di servizi AI, database, pipeline e applicazioni eseguite su Kubernetes, lo storage diventa un elemento essenziale per garantire affidabilità, prestazioni ed efficienza economica.


